
03 · INSTANCES & PARAMETERS
把引擎、模型和参数变成可复用实例
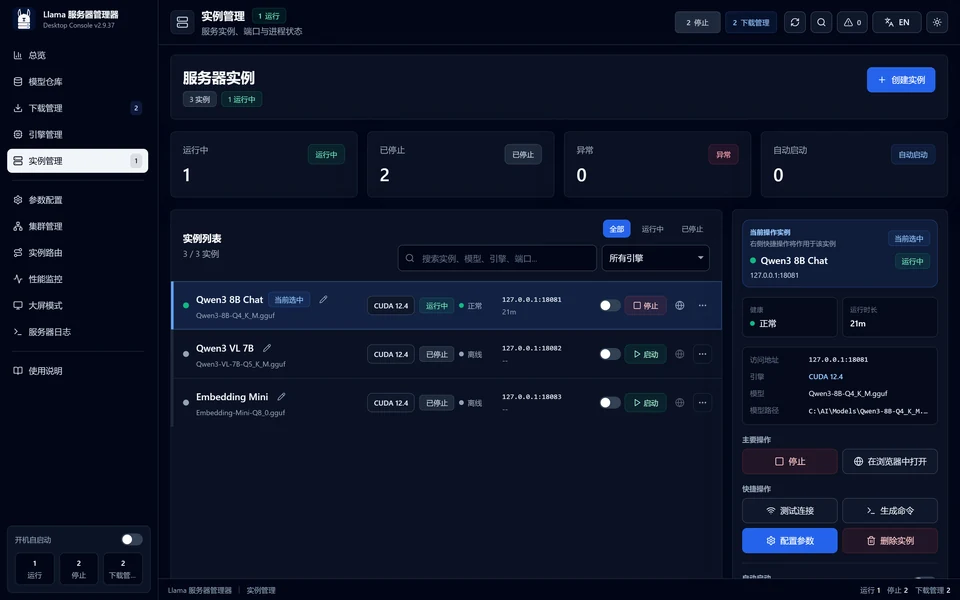
每个实例拥有独立端口、模型、后端和参数配置。先让自动值负责安全起步,再为明确目标建立显式覆盖。
创建实例
- 01选择工作负载
生成、Embedding 和 Reranker 使用不同的参数策略与性能指标,请先选对用途。
- 02绑定模型与引擎
选择已经扫描的 GGUF 与 llama-server。引擎能力决定哪些参数可以安全下发。
- 03分配监听地址和端口
只在本机使用时保留 127.0.0.1;需要局域网访问时再改为合适地址,并设置 API Key。
- 04保存并启动
启动前会检查路径、端口与配置。失败时先读顶部错误和服务器日志。
自动值与显式覆盖
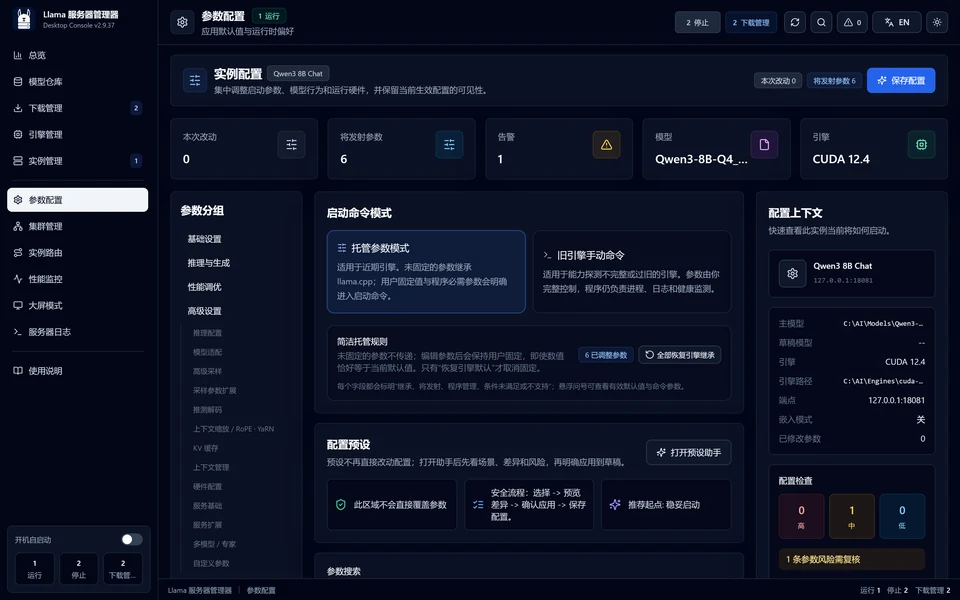
上下文大小、GPU 层数和线程等参数可以保持自动。应用只把明确启用或修改过的设置作为显式覆盖, 避免旧配置在引擎升级后无意覆盖新的 llama.cpp 默认值。
上下文先从模型默认或 4K / 8K 开始;更长上下文需要更多 KV Cache。
GPU 层数自动模式适合起步;显存不足时减少层数或降低 KV 精度。
批处理持续批处理默认有利于并发;只有明确测试需要时再关闭。
工具调用Claude Code / Anthropic 工具调用需要目标实例启用 Jinja。
实验性 KV / Prefill 缓存检查点
检查点默认关闭。在参数配置中启用后,先阅读资格检查结果,再应用所需的单 slot、prompt cache 和缓存容量设置。符合条件的实例会在受控停止时保存 slot 0,并在下次启动、代理开放路由前恢复。 客户端应使用管理器代理地址;直连实例端口不受恢复门禁保护。
MTP、DFlash、DSpark 等推测组合还取决于引擎是否明确支持相关状态持久化。模型或引擎不兼容时会冷启动; 已发送恢复请求后若验证失败,管理器会替换进程再冷启动。文件验证成功不代表实际前缀命中, 应结合 cached / processed token 和 prefill 时间判断。受控停止只保存当时的一个前缀。
存储维护
从侧栏打开“存储维护”,按类别查看临时文件、隔离文件、更新暂存和崩溃记录,审阅范围后执行清理。 WebView 缓存需要预约下次启动清理;外部缓存路径仅展示清单。清理受管临时文件前应停止所有实例。