
01 · GETTING STARTED
5 分钟启动第一个本地模型
先走最短路径:安装应用、准备一个 llama-server 引擎和 GGUF 模型,然后创建并启动实例。
开始之前
操作系统Windows 10/11、macOS 13+ 或现代 Linux
引擎与你的 CPU / GPU 后端匹配的 llama-server
模型一个可用的 GGUF 文件;首次体验建议选择较小模型
最短启动路径
- 01安装并打开应用
从下载页选择对应系统的安装包。首次运行出现来源提示时,核对文件名和 SHA-256 后继续。
- 02添加 llama-server 引擎
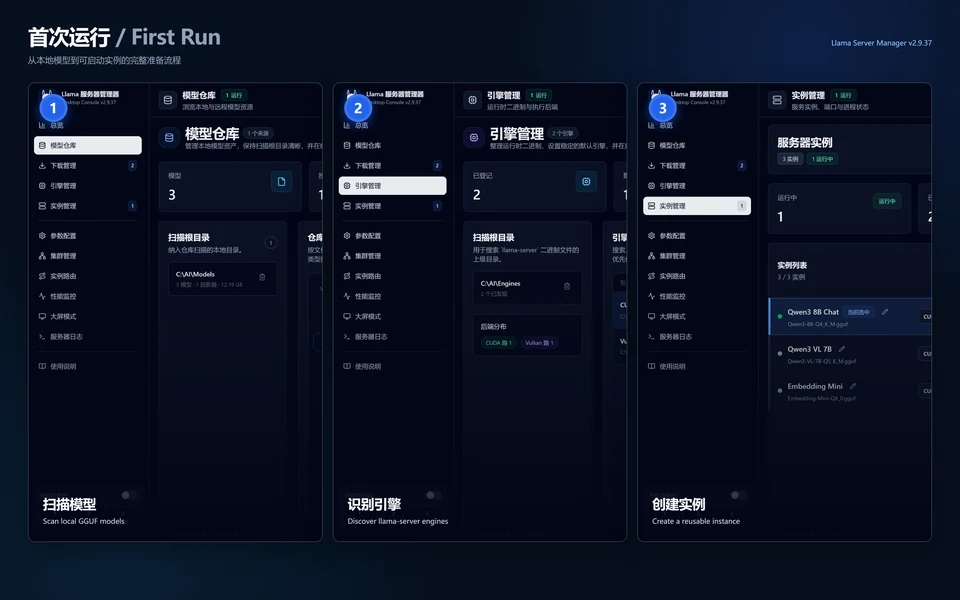
进入引擎管理,选择 llama-server 可执行文件所在目录。应用会检测版本、后端与支持参数。
- 03准备 GGUF 模型
在模型仓库页面从 ModelScope / Hugging Face 下载,或扫描现有本地模型目录。
- 04创建实例
在实例管理选择模型与引擎。保持上下文、GPU 层数和线程等选项为自动值即可先行验证。
- 05启动并检查健康状态
启动实例,等待状态变为运行中;再打开 llama-server Web UI 或通过 API 发起一个简单请求。
应用更新
Windows 与 macOS 的 v2.9.36 及以后版本会通过 Cloudflare R2 检查更新。发现新版本时,标题栏会显示版本入口; 只有你确认后才会下载、校验、安装并重启。运行中的实例或路由会在确认前明确提示。
自 v2.9.43 起 Linux 仅提供 DEB,AppImage 与 Linux 自动更新均已暂停。请在新版本发布后手动下载安装。